
Edellisessä osassa kävin läpi, miten aivot ja LLM erovat ja missä asioissa niissä on samaa. Nyt isketään kiinni LLM-ohjelmistoihin!
Mitä tapahtuu keskustelussa LLM:n kanssa
Kun kirjoitat kysymyksen ChatGPT:lle tai Claudelle, vastaus ei synny kerralla. Ensin teksti pilkotaan tokeneiksi, tokenit muutetaan luvuiksi, luvut lasketaan mallin matriisien läpi ja lopuksi saadaan todennäköisyysjakauma seuraavalle tokenille. Jakaumalta valitaan yksi token, se lisätään tekstin perään, ja koko kierros alkaa alusta. Näin vastaus syntyy token kerrallaan. Lopulta malli antaa itse lopetustokenin merkiksi siitä, että vastaus on valmis.
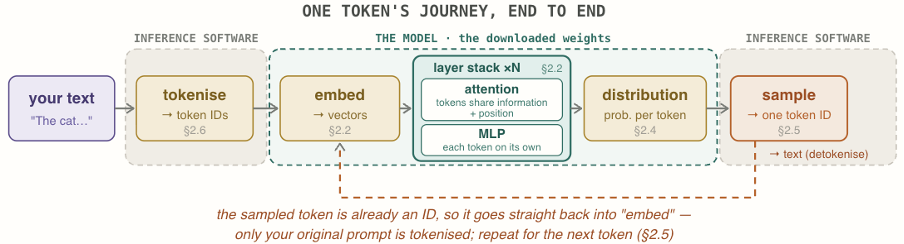
Kuva 1. Yhden tokenin matka tekstistä seuraavaan sanaan. Vihreän katkoviivan sisällä on itse malli: tokenit muutetaan vektoreiksi, ja vektorit kulkevat N kerroksen läpi. Jokaisessa kerroksessa on kaksi vaihetta: huomio ja MLP. Tässä blogissa käydään läpi kokonaisuus ja tokenisointi. Mallin sisällä tapahtuva laskenta on seuraavan blogin aihe. Kirjoittajan tekoälyllä luoma kuva.
Kuvassa on kaksi eri osaa. Ensimmäinen on itse malli eli ladattavat painot ja niiden arkkitehtuuri: se ottaa vastaan lukuja ja antaa ulos lukuja eikä näe tekstiä lainkaan. Keskustelun muistaminen on ympäröivän ohjelmiston tehtävä.
Mallin ympärillä on sitä pyörittävä ohjelmisto (inference engine), joka muuttaa kysymyksen tekstin tokeneiksi, tekee laskennan, valitsee seuraavan tokenin, pyörittää token-silmukkaa mallin läpi ja muuttaa lopputuloksen takaisin tekstiksi. Lisäksi ympärillä on muutakin, mutta siitä lisää myöhemmissä blogin osissa.
Mitä LLM sisältää?
LLM-maailman sanasto on hieman sekavaa, koska samoja sanoja käytetään osin eri asioista. Kun puhutaan mallin lataamisesta, ladataan joukko koulutuksessa syntyneitä lukuja eli painoja (weights). Niitä kutsutaan myös parametreiksi.
Malli (model) tarkoittaa painoja yhdessä arkkitehtuurikuvauksen kanssa: lukuja ja ohjetta siitä, miten niitä käytetään.
Se, minkä kanssa käyttäjä oikeasti keskustelee, on LLM-järjestelmä: malli sekä sen ympärillä oleva toimintaa ohjaava ohjelmisto.
Ladattavia painotiedostoissa on painomatriiseja, niissä ei ole todennäköisyyksiä. Ne määrittelevät kiinteän ja deterministisen funktion: sama syöte tuottaa aina saman tuloksen. Todennäköisyys syntyy vasta lopussa, kun malli tuottaa jakauman seuraavalle tokenille.
Edellisessä osassa mainitsin open weight -mallit. Useimmat niin sanotut avoimet mallit, niin kiinalaiset kuin länsimaisetkin, ovat nimenomaan avoimia painoja (open weights) eivätkä kokonaan avointa lähdekoodia (open source). Avoimet painot ovat ikään kuin valmis kakkupohja: sitä voisi jo syödä sellaisenaan tai ensin koristella haluamallaan tavalla. Avoin lähdekoodi sisältäisi myös kakun reseptin ja raaka-aineluettelon, jolloin kakkupohjan voisi halutessaan leipoa itse uudelleen. Avointe painojen mallin voi siis ajaa omilla koneilla ja jopa hienosäätää, mutta sen rakentamista ei voi itse toistaa eikä tarkistaa, millä datalla se on koulutettu.
Mitä tiedostoja mallissa on?
Otetaan konkreettinen esimerkki. Kun kiinalaisen DeepSeek-R1-mallin (DeepSeek-AI, 2025) lataa Hugging Face -palvelusta, joka on yksi avointen mallien jakelupaikoista, saa noin 689 gigatavua tiedostoja (Hugging Face, 2025). Lähes kaikki tuosta datamäärästä on painoja: 163 tiedostoa, joiden pääte on .safetensors. Painot on pilkottu enintään viiden gigatavun sirpaleiksi (shard) siksi, että ne olisi helpompi ladata. Jako tehdään koon mukaan, eikä yksittäinen sirpale vastaa mitään mallin osaa sinällään.
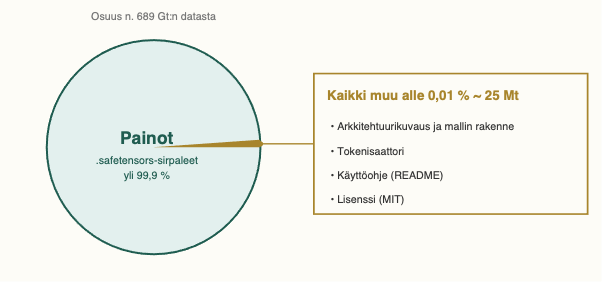
Kuva 2. DeepSeek-R1-mallin tiedostoista yli 99,9 % on painoja. Kirjoittajan tekoälyllä luoma kuva.
Loput tiedostot ovat pieniä mutta välttämättömiä. Arkkitehtuurikuvaus kertoo, miten luvut kytketään toimivaksi kokonaisuudeksi: DeepSeek-R1:ssä jokainen token kuvataan 7168 luvulla, ja kerroksia on 61 (Hugging Face, 2025). Tokenisaattori kertoo, miten teksti muutetaan tokeneiksi ja takaisin. Ilman sitä painot ovat käyttökelvottomia, ja siksi se toimitetaan aina painojen mukana. Lisäksi paketissa on käyttöohje ja lisenssin kuvaus, DeepSeek-R1:n tapauksessa MIT-lisenssi, joka sallii mallin vapaan käytön ja muokkaamisen.
Paketissa ei ole koulutusdataa eli niitä biljoonia tokeneita, joista malli oppi. Ei myöskään koulutukseen käytettyä koodia eikä optimoijan tilaa, jota tarvittaisiin alkuperäisen koulutuksen jatkamiseen siitä, mihin se jäi. Malli tarjoaa koulutuksen lopputuloksen, ei keinoja toistaa sitä itse. Tämä on ero avointen painojen ja avoimen lähdekoodin välillä. Täysin avoimia malleja on vähän, mutta esimerkiksi Allen Institute for AI:n OLMo on sellainen: painojen lisäksi myös koulutusdata ja -koodi on julkaistu (Groeneveld ym., 2024). Eurooppalainen OpenEuroLLM-hanke kehittää parhaillaan täysin avoimia malleja kaikille EU:n virallisille kielille, ja sitä johtaa yhdessä tšekkiläisen Kaarlen yliopiston kanssa suomalaislähtöinen AMD Silo AI (OpenEuroLLM, 2026).
DeepSeekin mallin tiedostot jakautuvat neljään ryhmään:
| Tiedostoryhmä | DeepSeek-R1:n tiedostot | Mitä ne sisältävät |
|---|---|---|
| Painot | model-00001-of-000163.safetensors … | Kaikki mallin oppimat luvut, yhteensä noin 689 Gt. |
| Arkkitehtuurikuvaus | config.json, configuration_deepseek.py, modeling_deepseek.py, generation_config.json | Mallin koko ja rakenne (7168 lukua per token, 61 kerrosta, sanaston koko, kontekstin maksimipituus…), mallin koodi ja tekstin tuottamisen oletusasetukset. |
| Tokenisaattori | tokenizer.json, tokenizer_config.json, special_tokens_map.json | Sanasto ja yhdistämissäännöt, joilla teksti muutetaan tokeneiksi ja takaisin. |
| Ohjeet ja lisenssi | README, LICENSE | Mallin kuvaus, käyttöohjeet ja MIT-lisenssi. |
Mistä painot malliin tulevat?
Kenenkään ei ole tarvinnut kirjoittaa mallin satoja miljardeja lukuja käsin. Ne syntyvät koulutuksessa, jonka perusidean kävin läpi osassa 1: malli arvaa seuraavan tokenin, arvauksen virhe mitataan ja jokaista painoa siirretään hieman suuntaan, joka pienentää virhettä. Sitten sama toistetaan valtavan monta kertaa. Virheen mittaa virhefunktio (loss), ja vastavirta-algoritmi (backpropagation) laskee, kuinka paljon kukin paino vaikutti virheeseen. Itse säätö tehdään gradienttimenetelmällä (gradient descent). Pienen kielimallin voi myös rakentaa ja kouluttaa täysin itse, ja siihen löytyy paljon ohjeistusta, kuten Girish Guptan Build an LLM -sivusto, jossa koko prosessin voi käydä läpi vaihe vaiheelta.
Koulutus tapahtuu kahdessa vaiheessa, jotka tuottavat kaksi eri asiaa: ensin mallin tiedot, sitten sen avuliaisuuden (helpfulness) eli kyvyn toimia avustajana. Tämä tarkoittaa kykyä vastata kysymykseen, noudattaa ohjeita ja pysyä asiassa.
Ensimmäisessä vaiheessa, esikoulutuksessa (pre-training), mallille näytetään biljoonia tokeneita tekstiä. Kukaan ei opeta sille kielioppia tai faktoja, vaan ne syntyvät itsestään, kun ohjelmisto löytää tokeneiden esiintymisessä säännönmukaisuuksia. Tuloksena on pohjamalli (base model), joka tietää, mutta ei osaa avustaa. Jos pohjamallilta kysyy jotain, se saattaa jatkaa tekstiä kolmella uudella kysymyksellä, koska se on oppinut jatkamaan tekstiä, ei auttamaan.
Avustajaksi pohjamalli muuttuu toisessa vaiheessa, jälkikoulutuksessa (post-training). Ensin mallia hienosäädetään esimerkkidialogeilla, joissa on valittuja kysymys–vastaus-pareja (ohjattu hienosäätö, supervised fine-tuning). Sen jälkeen ihmiset tai toinen tekoäly vertailevat mallin vastauksia ja merkitsevät, kumpi on parempi, ja mallia ohjataan suosimaan parempia vastauksia. Tätä kutsutaan vahvistusoppimiseksi ihmispalautteesta (reinforcement learning from human feedback, RLHF; Ouyang ym., 2022). Jos arvioijana on tekoäly, puhutaan RLAIF-menetelmästä (reinforcement learning from AI feedback; Bai ym., 2022). Tässä vaiheessa malli oppii noudattamaan ohjeita, myöntämään, ettei tiedä jotain, ja kieltäytymään haitallisiksi katsotuista pyynnöistä.
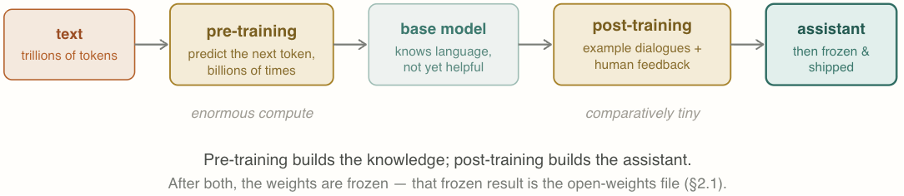
Kuva 3. Kaksi koulutusvaihetta, kaksi tuotetta. Esikoulutus tekee biljoonista tokeneista tietävän pohjamallin, jälkikoulutus tekee siitä avuliaan ja turvallisen avustajan. Sen jälkeen painot jäädytetään. Kirjoittajan tekoälyllä luoma kuva.
Koulutuksen jälkeen painot jäädytetään ja tallennetaan tiedostoihin käyttöä varten. Kun mallia käytetään, painot eivät enää muutu: kaikki, mitä keskustelussa tapahtuu, on jäädytetyn mallin ajamista.
Jälkikoulutus on pieni esikoulutukseen verrattuna: se muokkaa mallin käytöstä mutta ei opeta maailmaa uudelleen. Siksi pienempää avointa mallia voi hienosäätää jopa kotilaitteilla, mutta sen esikouluttaminen uudelleen vaatisi valtavat resurssit. Kieltäytyminen haitallisiksi katsotuista pyynnöistä opitaan jälkikoulutuksessa, joten sen voi myös kouluttaa pois. Siksi verkosta löytyy ”uncensored”-versioita avoimista malleista. Tämä on avoimiin painoihin liittyvä turvallisuuskysymys: kuka tahansa voi periaatteessa jälkikouluttaa mallin omien tarkoitustensa mukaiseksi.
Tekstistä tokeneiksi
Malli ei näe sanoja tai edes kirjaimia, vaan tokeneita. Token on tekstin palanen: yleinen sana, sanan osa tai joskus yksittäinen merkki. Englannissa token on keskimäärin noin kolme neljäsosaa sanasta. Tokenisaattori (tokeniser) on ikään kuin mallin sanakirja. Teknisesti se on hakutaulukko, jossa jokaisella tokenilla on oma kokonaislukutunniste (ID).
Kun kirjoitat kysymyksen, tokenisaattori muuttaa sen tunnisteiksi, ja lopuksi vastauksen tunnisteet muutetaan takaisin tekstiksi. Voit kokeilla itse, miten teksti pilkkoutuu tokeneiksi, esimerkiksi OpenAI:n tokenisaattorilla. Transformer Explainer -työkalun visualisoinnin alkuosasta (Embedding) näet lisäksi, miten tokenit saavat tunnisteensa ja muuttuvat malliin syötettäviksi luvuiksi.
Sanastoa ei kirjoiteta käsin, vaan se opitaan datasta ennen mallin koulutusta. Yleisin menetelmä on BPE (Byte-Pair Encoding; Sennrich ym., 2016). Se aloittaa yksittäisistä merkeistä, etsii suuresta tekstiaineistosta useimmin vierekkäin esiintyvän parin, yhdistää sen uudeksi tokeniksi ja toistaa saman kymmeniä tai satoja tuhansia kertoja. Lopputuloksena on tyypillisesti 50 000–250 000 tokenin sanasto. Sanan osat ovat kompromissi kahden huonon ääripään välillä: jos jokainen kirjain olisi oma tokeninsa, tekstit olisivat hyvin pitkiä jonoja, ja jos jokainen sana olisi oma tokeninsa, sanastosta tulisi valtava eikä malli selviäisi sanoista, joita se ei ole nähnyt.
Tokenisaattorin valinta on mallin suunnittelupäätös, joka tehdään ennen koulutusta ja joka on sen jälkeen hitsattu painoihin kiinni. Sitä ei voi vaihtaa jälkikäteen ilman, että malli koulutettaisiin uudestaan. Tokenisaattorin ajaminen on mallin ympärillä olevan ohjelmiston tehtävä, ei itse mallin.
Suomen kielen kannalta tällä on merkitystä. Sanastot rakennetaan yleensä englantipainotteisesta aineistosta, joten englanti pilkkoutuu tehokkaasti, usein kokonaisiksi sanoiksi. Suomi taas hajoaa useampiin palasiin. Koska AI-käytön hinnoittelu, keskustelun enimmäispituus ja usein myös laatu riippuvat tokeneiden määrästä, englantipainotteisesta aineistosta rakennettu tokenisaattori asettaa muut kielet huomaamatta heikompaan asemaan (Petrov ym., 2023). Sama keskustelu englanniksi kuluttaa siksi yleensä vähemmän tokeneita ja on näin halvempaa.
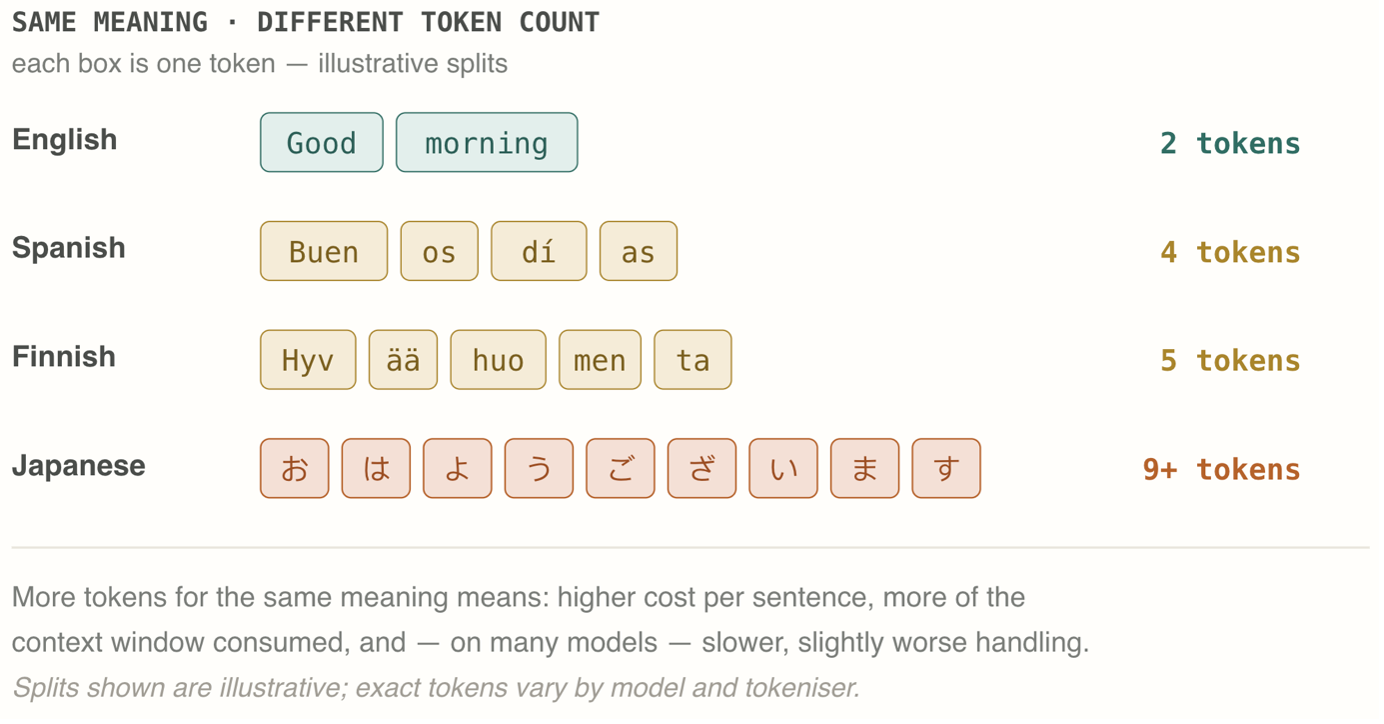
Kuva 4. Sama tervehdys voisi pilkkoutua tokeneiksi neljällä kielellä tällä tavalla. Kirjoittajan tekoälyllä luoma kuva.
Tokenisointi selittää myös kielimallien kummallisuuksia. Koska malli näkee tekstin palasina eikä kirjaimina, sen voi olla vaikea laskea sanan kirjaimia, kirjoittaa sanaa takaperin tai keksiä riimejä.
Kuuluisa esimerkki on kysymys siitä, montako r-kirjainta on sanassa ”strawberry”. Vuonna 2024 moni malli vastasi itsevarmasti ”kaksi”, ja aiheesta löytyy YouTubesta paljon hauskoja videoita. Uusimmat mallit vastaavat yleensä jo oikein, koska ne ovat oppineet tällaisissa tehtävissä kirjoittamaan sanan ensin auki kirjain kerrallaan, jolloin jokaisesta kirjaimesta tulee oma tokeninsa. Ongelma ei silti ole kokonaan kadonnut: malli ei edelleenkään näe kirjaimia suoraan. Harvinaisemmilla sanoilla tai pitkillä merkkijonoilla virheitä voi tulla.
Terminologiasta
Lopuksi vielä tämän osan keskeiset termit suomeksi ja englanniksi. Kaikille ei ole vakiintunutta termiä suomeksi.
| Suomeksi | Englanniksi | Selitys |
|---|---|---|
| Painot, parametrit | weights, parameters | Mallin matriisien kiinteät luvut eli ladattavien tiedostojen sisältö. |
| Malli | model | Painot ja arkkitehtuurikuvaus yhdessä: ajettava kokonaisuus. |
| LLM-järjestelmä | LLM system | Malli sekä sen ympärillä oleva ohjelmisto: mm. tokenisaattori, tokenin valinta ja silmukka. Tämä on se kokonaisuus, jonka kanssa käyttäjä toimii. |
| Avoimet painot | open weights | Painot ja tokenisaattori on julkaistu: mallin voi ajaa ja hienosäätää, mutta koulutusta ei voi toistaa. |
| Avoin lähdekoodi | open source | Avoimet painot sekä koulutusdata ja -koodi: mallin koulutuksen voisi myös toistaa. |
| Sirpale | shard | Yksi painojen osatiedostoista. Painot jaetaan osiin, jotta valtavan datamäärän lataaminen olisi helpompaa. |
| Esikoulutus | pre-training | Seuraavan tokenin ennustamisen opettelua edeltävien tokeneiden perusteella biljoonien tokeneiden koulutusaineistolla. Tuottaa pohjamallin. |
| Pohjamalli | base model | Esikoulutuksen tulos: osaa laskea todennäköisyydet seuraavalle tokenille, mutta ei vielä osaa avustaa käyttäjää. |
| Jälkikoulutus | post-training | Ohjattu hienosäätö ja vahvistusoppiminen, jotka tekevät pohjamallista avustajan. |
| Token | token | Tekstin palanen: sana, sanan osa tai merkki. |
| Tokenisaattori | tokeniser | Muuttaa tekstin tokeneiden tunnisteiksi ja takaisin. |
| BPE | Byte-Pair Encoding | Yleisin menetelmä, jolla tokenisaattorin sanasto opitaan. |
Seuraavassa osassa
Seuraavassa osassa tutkitaan, mitä tapahtuu, kun mallille kirjoitetaan kysymys: miten tokenit muuttuvat luvuiksi, miten tokenit ottavat toisensa huomioon, miten seuraava token valitaan ja miksi malli näyttää joskus keksivän asioita.
Lue lisää aiheesta
Elements of AI: Helsingin yliopiston maksuton verkkokurssi tekoälyn perusteista suomeksi. https://www.elementsofai.fi
OpenAI Tokenizer: kokeile itse, montako tokenia sama lause vie suomeksi ja englanniksi. https://platform.openai.com/tokenizer
Transformer Explainer: Georgia Techin interaktiivinen visualisointi, jossa selaimessa toimiva GPT-2-malli näyttää tokenisoinnin, upotukset ja huomiomekanismin vaihe vaiheelta. https://poloclub.github.io/transformer-explainer/
AnimatedLLM: maallikoille tehty animaatio siitä, miten kielimalli käsittelee tokeneita vaihe vaiheelta. https://animatedllm.github.io/
Build an LLM: Girish Guptan opetussivusto, jolla pienen kielimallin voi kouluttaa itse alusta alkaen. https://buildanllm.com/
3Blue1Brown: Neural networks -videosarja YouTubessa, erityisesti jaksot kielimalleista ja transformereista. Havainnollinen visuaalinen johdatus aiheeseen! https://www.youtube.com/playlist?list=PLZHQObOWTQDNU6R1_67000Dx_ZCJB-3pi
Andrej Karpathy: Intro to Large Language Models ja Deep Dive into LLMs like ChatGPT -videot YouTubessa. Yleistajuinen läpikäynti koulutuksesta, tokenisoinnista ja jälkikoulutuksesta. https://www.youtube.com/watch?v=zjkBMFhNj_g ja https://www.youtube.com/watch?v=7xTGNNLPyMI
What is ChatGPT doing … and why does it work?: Stephen Wolframin perusteellinen kuvaus siitä, miten ChatGPT tuottaa tekstiä sana kerrallaan. https://writings.stephenwolfram.com/2023/02/what-is-chatgpt-doing-and-why-does-it-work/
Hugging Face LLM Course: maksuton kurssi kielimalleista, myös tokenisaattoreista. https://huggingface.co/learn/llm-course
Lähteet
Bai, Y. ym. (2022). Constitutional AI: Harmlessness from AI feedback. arXiv. https://arxiv.org/abs/2212.08073
DeepSeek-AI. (2025). DeepSeek-R1: Incentivizing reasoning capability in LLMs via reinforcement learning. arXiv. https://arxiv.org/abs/2501.12948
Groeneveld, D. ym. (2024). OLMo: Accelerating the science of language models. arXiv. https://arxiv.org/abs/2402.00838
Hugging Face. (2025). deepseek-ai/DeepSeek-R1 [Mallin tiedostot]. https://huggingface.co/deepseek-ai/DeepSeek-R1
OpenEuroLLM. (2026, 6. maaliskuuta). OpenEuroLLM: First year progress and next steps. https://openeurollm.eu/blog/first-year-progress-and-next-steps
Ouyang, L. ym. (2022). Training language models to follow instructions with human feedback. Advances in Neural Information Processing Systems, 35. https://arxiv.org/abs/2203.02155
Petrov, A., La Malfa, E., Torr, P. H. S., & Bibi, A. (2023). Language model tokenizers introduce unfairness between languages. Advances in Neural Information Processing Systems, 36. https://arxiv.org/abs/2305.15425
Sennrich, R., Haddow, B., & Birch, A. (2016). Neural machine translation of rare words with subword units. Proceedings of the 54th Annual Meeting of the ACL, 1715–1725. https://arxiv.org/abs/1508.07909