
Edellisessä osassa kävin läpi, mistä kielimalli koostuu ja miten sen painot syntyvät. Nyt katsotaan, mitä tapahtuu, kun mallille kirjoitetaan kysymys.
Kertaus kokonaiskuvasta
Tiedostoina ladattava malli on joukko jäädytettyjä lukuja eli painoja, ja tokenisaattori pilkkoo tekstin tokeneiksi ja antaa jokaiselle oman kokonaislukutunnisteen. Tässä osassa seurataan yhtä kehotetta alusta loppuun: mitä tapahtuu sen jälkeen, kun kysymyksesi on muutettu tunnisteiksi, ja miten niistä syntyy vastaus sana kerrallaan.
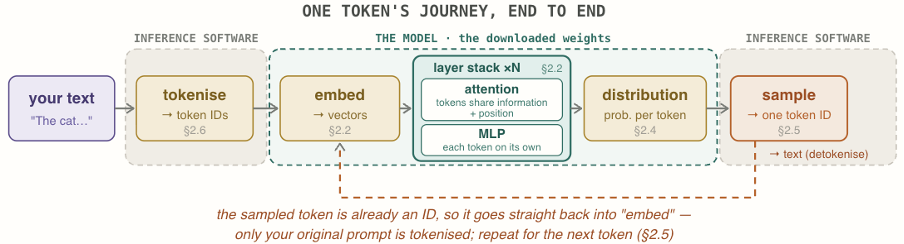
Kuva 1. Yhden tokenin matka tekstistä seuraavaan sanaan. Tässä blogissa käydään läpi kaikki prosessin vaiheet. Lopuksi esitellään katkoviivalla merkitty silmukka, jossa valittu token syötetään takaisin malliin ja vastaus syntyy token kerrallaan. Kirjoittajan tekoälyllä luoma kuva.
Vinkki: AnimatedLLM-sivulla voi itse seurata animaationa, miten kielimalli käsittelee tokeneita vaihe vaiheelta.
Tokeneista luvuiksi: upotustaulukko
Tokenisaattorin tuottama tunniste on pelkkä järjestysnumero. Sanalla ”cat” voi olla tunniste 4, mutta luvusta 4 ei voi päätellä mitään sanan merkityksestä. Siksi ensimmäinen askel mallin sisällä on hakea jokaiselle tunnisteelle sitä vastaava rivi suuresta taulukosta, jota kutsutaan upotustaulukoksi (embedding table). Kyse on pelkästä hausta, ei laskutoimituksesta: tunniste 4 tarkoittaa yksinkertaisesti, että taulukosta luetaan rivi 4.
Rivi on vektori eli jono lukuja. Osassa 1 puhuin aktivaatiovektoreista, joilla malli kuvaa asioita sisäisesti. Jokainen token saa oman aktivaatiovektorinsa, ja näitä lukuja mallin kerrokset seuraavaksi muokkaavat. Kuvan 2 vektorissa on tässä esimerkissä neljä lukua (oikeasti esim. DeepSeek-R1:ssä niitä on 7168). Taulukossa on yksi rivi jokaista mallin sanaston tokenia kohden, eli DeepSeekin tapauksessa 129 280 riviä, joissa kussakin on 7168 lukua. Pelkkä upotustaulukko sisältää siis lähes miljardi lukua.
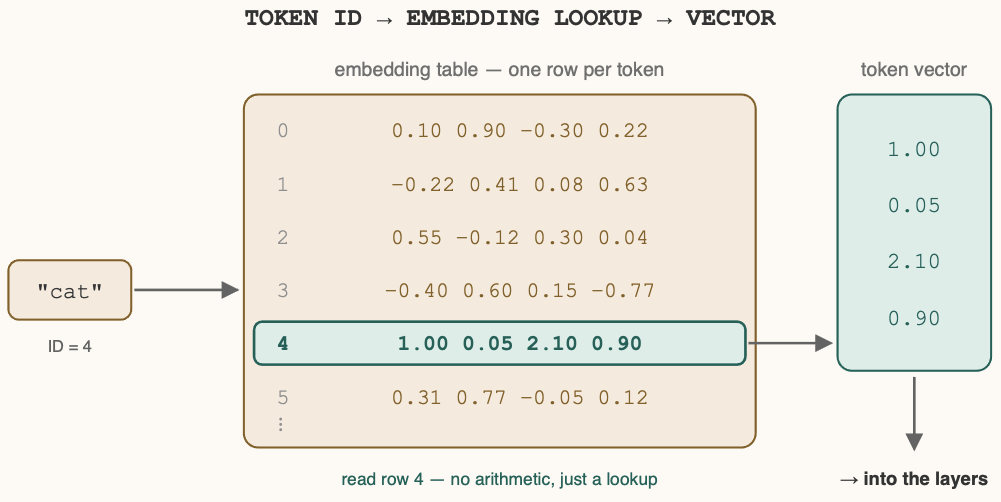
Kuva 2. Tunnisteesta vektoriksi. Tokenin ”cat” tunniste 4 osoittaa upotustaulukon rivin, joka luetaan sellaisenaan tokenin vektoriksi. Tieto tokenin paikasta lauseessa lisätään varhaisemmissa malleissa tässä vaiheessa, nykymalleissa vasta huomiossa. Kirjoittajan tekoälyllä luoma kuva.
Taulukon rivit ovat opittuja painoja. Kukaan ei ole päättänyt, mitä yksittäiset luvut tarkoittavat. Koulutus on siirtänyt samankaltaisissa yhteyksissä esiintyvät sanat lähelle toisiaan, joten ”kissan” ja ”koiran” vektorit muistuttavat toisiaan enemmän kuin ”kissan” ja ”verotuksen”.
Vektoria voi ajatella nuolena, joka osoittaa johonkin suuntaan. Hyvä vertailukohta on väri: näytöllä jokainen väri on kolme lukua eli punaisen, vihreän ja sinisen määrä. Kun siniseen lisätään punaista, syntyy violetti, ja sinertävä sävy on kallellaan sinistä kohti. Mallin vektorit toimivat samoin, mutta perusvärejä on kolmen sijaan tuhansia. Merkitys ei ole yksittäisessä luvussa vaan suunnassa, joka syntyy kaikkien lukujen yhdistelmästä. Samankaltaiset sanat osoittavat suunnilleen samaan suuntaan.
Myös sanojen väliset suhteet näkyvät suuntina (ks. Kuva 3). Yksinkertaistettuna nuoli sanasta ”mies” sanaan ”nainen” on lähes sama kuin nuoli sanasta ”kuningas” sanaan ”kuningatar” (Mikolov ym., 2013). Malli ei siis tallenna erikseen, että kuningatar on naispuolinen kuningas, vaan suhde on yksi suunta, jota käytetään monessa sanaparissa. Todellisissa malleissa suunnat ovat harvoin näin siistejä, eikä useimmille niistä ole ihmisen ymmärtämää nimeä.
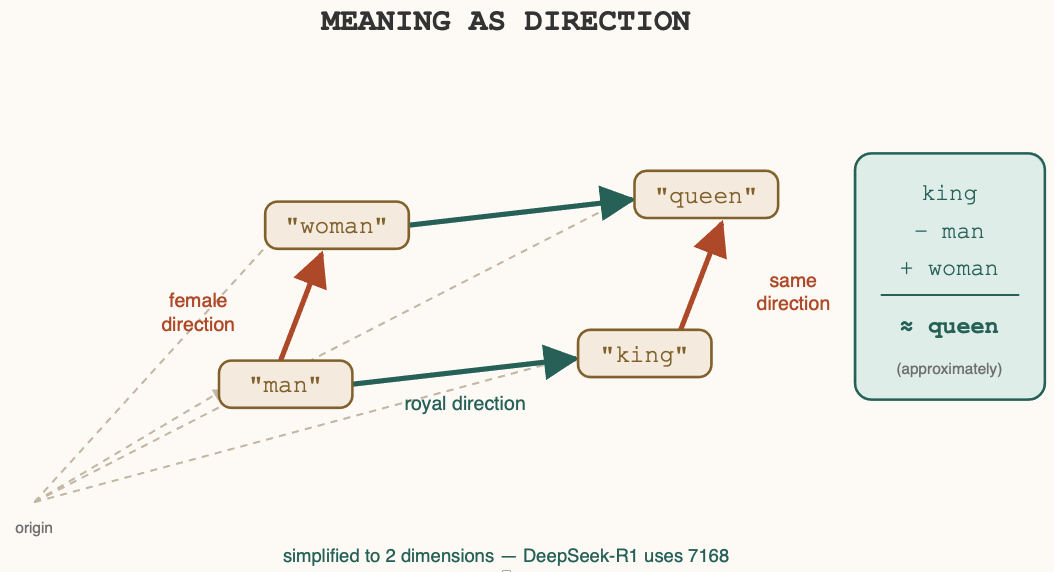
Kuva 3. Merkitys suuntana. Nuoli sanasta ”man” sanaan ”woman” on lähes sama kuin nuoli sanasta ”king” sanaan ”queen”. Kuva on yksinkertaistettu kahteen ulottuvuuteen. Kirjoittajan tekoälyllä luoma kuva.
Upotustaulukko ei kuitenkaan kerro, missä kohdassa lausetta token on. Englannin ”dog bites man” ja ”man bites dog” sisältävät samat sanat, mutta merkitys on päinvastainen. Siksi malliin tuodaan tieto tokenin paikasta (sijaintikoodaus, positional encoding). Varhaisemmissa transformereissa paikkatieto lisättiin vektoriin heti upotuksen jälkeen. Useimmissa nykymalleissa, myös DeepSeekissä, paikkatieto tuodaan mukaan vasta huomion laskennassa, jokaisessa kerroksessa erikseen. Palaan tähän huomiomekanismin yhteydessä.
Huomiomekanismi: miten tokenit katsovat toisiaan
Upotuksen jälkeen jokaisella tokenilla on oma vektorinsa, mutta tokenit eivät vielä tiedä toisistaan mitään. Sanan ”se” vektori on sama riippumatta siitä, viittaako se kissaan, laatikkoon vai säähän. Huomiomekanismi (attention) on se osa mallia, jossa tokenit katsovat toisiaan ja hakevat toisiltaan tietoa. Se on vuonna 2017 esitellyn transformer-arkkitehtuurin tärkein osa (Vaswani ym., 2017), ja sen varaan on rakennettu lähes kaikki nykyiset kielimallit.
Kuvan esimerkissä malli käsittelee englanninkielistä lausetta ”The cat chased prey until it”. Kun malli on tokenin ”it” kohdalla, se laskee, kuinka paljon huomiota kukin aiempi token saa. Huomio jakautuu tokeneiden kesken niin, että osuuksien summa on yksi. Tätä kutsutaan huomiojakaumaksi (attention distribution). Jakauman suurin osuus, tässä esimerkissä 60 prosenttia huomiosta, osoittaa sanaan ”cat”: malli on päätellyt, että ”it” tarkoittaa kissaa.
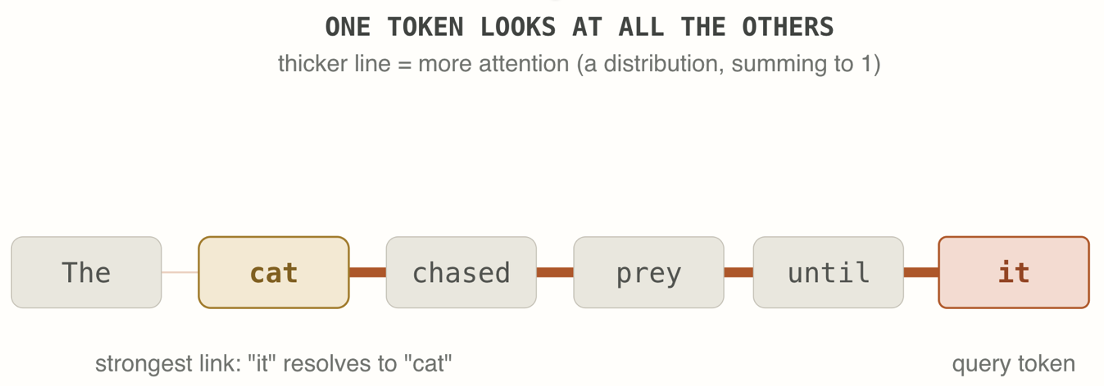
Kuva 4. Yksi token katsoo kaikkia muita. Mitä paksumpi viiva, sitä enemmän huomiota. Tokenin ”it” vahvin yhteys on sanaan ”cat”. Kirjoittajan tekoälyllä luoma kuva.
Tässä kohdassa kannattaa erottaa kaksi asiaa, joita molempia kutsutaan painoiksi. Mallin tiedostoissa on kiinteitä, tallennettuja matriiseja, jotka ovat samat kaikille käyttäjille ja kaikille lauseille. Huomiopainot taas lasketaan jokaiselle lauseelle erikseen, ja ne heitetään pois heti käytön jälkeen. Yhteyttä sanasta ”it” sanaan ”cat” ei siis ole tallennettu mihinkään tiedostoon, vaan malli laskee sen joka kerta uudelleen.
Miten huomiojakauma sitten lasketaan? Jokaisesta tokenin vektorista muodostetaan ensin kolme uutta vektoria: kysely (query), avain (key) ja arvo (value). Ne voi ajatella kirjaston hakuna. Kysely kertoo, mitä token etsii, avain kertoo, mitä kukin token tarjoaa, ja arvo on sisältö, joka välitetään eteenpäin, jos avain sopii kyselyyn. Vektorit saadaan kertomalla tokenin vektori kolmella tallennetulla matriisilla samaan tapaan kuin osassa 1 kuvatussa matriisilaskussa. Nämä matriisit ja lopuksi tulokset yhdistävä matriisi ovat ainoat kohdat, joissa huomiomekanismi käyttää tiedostoon tallennettuja lukuja. Tässä vaiheessa mukaan tulee myös paikkatieto: kysely- ja avainvektoreita kierretään sitä enemmän, mitä pidemmällä token on tekstissä (kiertosijaintikoodaus, rotary position embedding). Paikka muuttaa siis vektorin suuntaa, ja kahden tokenin vertailusta näkyy suoraan, kuinka kaukana ne ovat toisistaan.
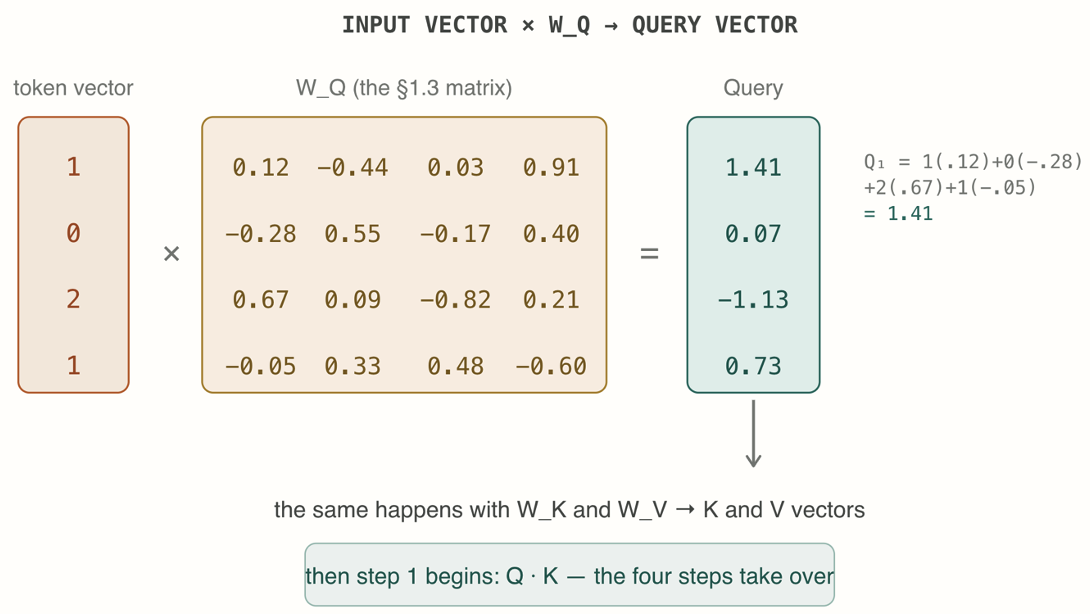
Kuva 5. Tokenin vektori kerrotaan kyselymatriisilla (W_Q), jolloin saadaan kyselyvektori. Samalla tavalla avain- ja arvomatriisit (W_K ja W_V) tuottavat avain- ja arvovektorit. Kirjoittajan tekoälyllä luoma kuva.
Itse huomio lasketaan neljässä vaiheessa:
- Vertailu: tokenin ”it” kyselyä verrataan jokaisen muun tokenin avaimeen. Vertailu on pistetulo (dot product): mitä paremmin kaksi vektoria osoittaa samaan suuntaan, sitä suurempi luku syntyy. Kyse on siis samasta suuntien vertailusta, jota käytettiin upotuksen yhteydessä.
- Skaalaus: luvut jaetaan vakiolla, jotta ne eivät kasva liian suuriksi.
- Softmax: softmax-funktio muuttaa luvut positiivisiksi osuuksiksi, joiden summa on yksi. Nämä osuudet ovat huomiopainot, ja yhdessä ne muodostavat huomiojakauman.
- Painotettu summa: jokaisen tokenin arvo kerrotaan sen huomiopainolla ja tulokset lasketaan yhteen.
Koska ”cat” sai 60 prosenttia huomiosta, painotettu summa koostuu pääosin kissan arvosta. Summa lisätään tokenin ”it” omaan vektoriin. Silloin ”it” ei muutu kissaksi, vaan se saa mukaansa tiedon siitä, mihin se viittaa.
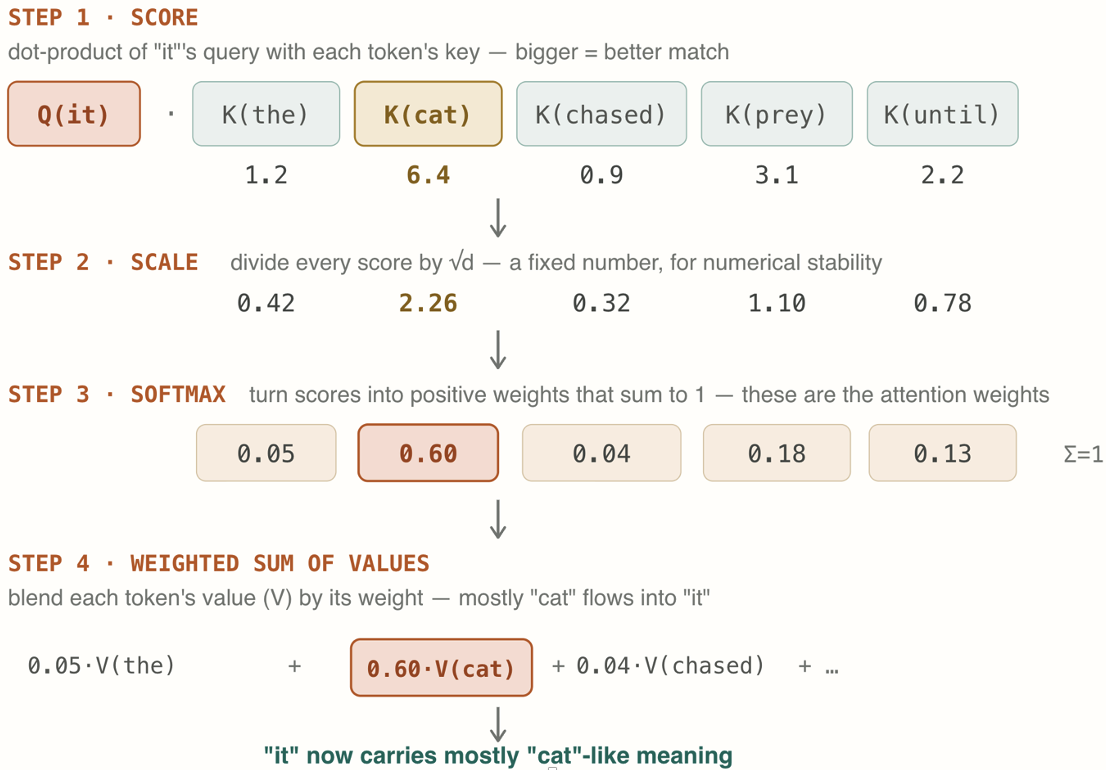
Kuva 6. Huomiomekanismin neljä vaihetta: vertailu, skaalaus, softmax ja painotettu summa. Lopputuloksena ”it” kantaa mukanaan enimmäkseen sanan ”cat” merkitystä. Kirjoittajan tekoälyllä luoma kuva.
Huomiolla on hintansa. Koska jokainen token vertaa itseään jokaiseen aiempaan tokeniin, laskennan määrä kasvaa tekstin pituuden neliössä: kaksi kertaa pidempi teksti vaatii noin neljä kertaa enemmän vertailuja. Tämä on yksi syy siihen, miksi pitkät keskustelut ja pitkät dokumentit ovat kalliita käsitellä.
Vinkki: Transformer Explainer -työkalussa voi kirjoittaa oman lauseen ja nähdä, mihin muihin tokeneihin kukin token kiinnittää huomiota.
Monta huomiojakaumaa yhtä aikaa: huomiopäät ja kerrokset
Yksi huomiojakauma ei riitä, koska sanojen välillä on monenlaisia suhteita. Siksi mallissa on useita huomiopäitä (attention head), jotka laskevat huomion rinnakkain. Jokaisella päällä on omat kysely-, avain- ja arvomatriisinsa ja siten oma huomiojakaumansa. Kukaan ei määrää, mihin kukin pää keskittyy. Työnjako syntyy koulutuksessa itsestään, koska se auttaa ennustamaan seuraavaa tokenia.
Kuvan lauseessa ”The tired cat that chased the mouse finally slept” neljä päätä löytää neljä eri yhteyttä. Yksi yhdistää verbin ”slept” sen tekijään ”cat” sivulauseen yli, toinen adjektiivin ”tired” sanaan ”cat”, kolmas verbin ”chased” sen kohteeseen ”mouse” ja neljäs vierekkäiset sanat toisiinsa. Todellisissa malleissa päiden roolit ovat harvoin näin siistejä, mutta tämänkaltaisia erikoistuneita päitä on löydetty malleja tutkittaessa.
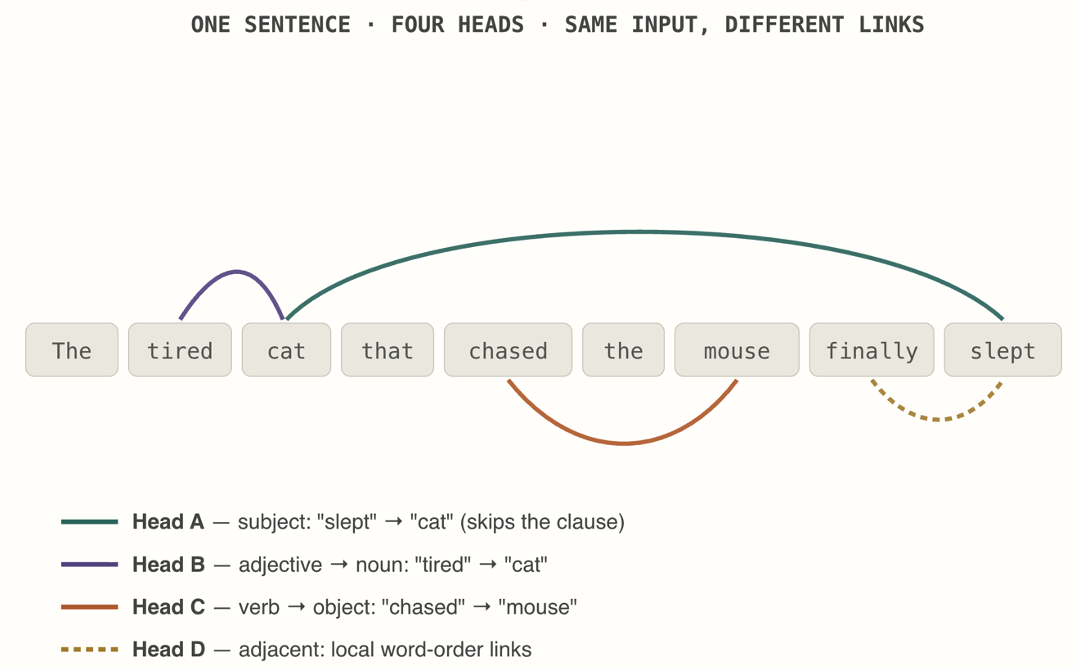
Kuva 7. Sama lause, neljä huomiopäätä ja neljä eri yhteyttä. Jokainen pää oppii koulutuksessa seuraamaan omanlaistaan suhdetta. Kirjoittajan tekoälyllä luoma kuva.
Huomion jälkeen jokainen vektori kulkee vielä kerroksen toisen osan läpi. Sitä kutsutaan MLP-osaksi (multilayer perceptron) tai syöttöeteenpäin-verkoksi (feed-forward network). Siinä missä huomiossa tokenit vaihtavat tietoa keskenään, MLP-osassa jokaista tokenia käsitellään yksin.
MLP-osassa on kaksi matriisia eli lukutaulukkoa, joiden luvut ovat opittuja painoja. Ensimmäisen matriisin jokainen rivi on yhtä pitkä kuin tokenin vektori. Kertolaskussa vektoria verrataan vuorollaan jokaiseen riviin samalla pistetulolla kuin huomiossa, ja jokaisesta vertailusta syntyy yksi luku. Rivejä on moninkertaisesti enemmän kuin vektorissa on lukuja, joten tuloksena on paljon pidempi vektori. Esimerkiksi DeepSeek-R1:n ensimmäisissä kerroksissa 7168 luvun vektorista tulee 18 432 luvun vektori.
Rivit voi ajatella kysymyksinä: onko vektori kallellaan tähän suuntaan? Mitä paremmin vektori osoittaa samaan suuntaan kuin rivi, sitä suurempi luku syntyy. Kukaan ei taaskaan ole kirjoittanut näitä kysymyksiä, vaan koulutus on muokannut rivit sellaisiksi, että niistä on hyötyä seuraavan tokenin ennustamisessa.
Sen jälkeen jokainen luku kulkee aktivaatiofunktion (activation function) läpi. Nimestä huolimatta se ei ole sama asia kuin osassa 1 mainitut aktivaatiovektorit: vektorit ovat lukuja, jotka kulkevat mallin läpi, ja aktivaatiofunktio on yksi vaihe, jossa niitä muokataan. Yksinkertaisin aktivaatiofunktio, ReLU, toimii kuin kynnys: negatiiviset luvut muutetaan nolliksi ja positiiviset päästetään läpi sellaisinaan. Kielteinen vastaus sammuu siis kokonaan, ja vain myönteiset vastaukset vaikuttavat jatkoon. Nykymallit käyttävät pehmeämpiä muunnelmia, mutta periaate on sama. Toisin kuin huomion softmax, aktivaatiofunktio ei vertaa lukuja keskenään, vaan käsittelee jokaisen erikseen.
Lopuksi MLP-osan toinen matriisi palauttaa pitkän vektorin takaisin alkuperäiseen kokoonsa. Sen jokainen rivi vastaa yhtä ensimmäisen matriisin kysymystä, ja rivi on yhtä pitkä kuin tokenin vektori, eli se on itsekin suunta. Jokainen myönteinen vastaus lisää tulokseen oman suuntansa, ja mitä vahvempi vastaus, sitä enemmän. Tulos on siis painotettu summa niistä suunnista, joiden kysymyksiin vastaus oli myönteinen, ja se lisätään tokenin vektoriin. Yksinkertaistettuna: jos ensimmäinen matriisi tunnistaa, että vektori viittaa Pariisiin, toinen voi lisätä siihen Ranskaa tarkoittavan suunnan.
Huomio vastaa siis kysymykseen ”mihin muihin sanoihin katson?”, MLP-osa kysymykseen ”mitä tiedän tästä?”. Jokaisella kerroksella on omat MLP-matriisinsa, ja tavallisessa mallissa kaikki saman kerroksen tokenit kerrotaan samoilla matriiseilla. Poikkeuksen tekevät asiantuntijakerrokset, joista kerron alla.
Valtaosa mallin painoista on MLP-osien matriiseissa, ja tutkimusten mukaan suuri osa mallin oppimasta faktatiedosta näyttää tallentuneen juuri niihin (Geva ym., 2021).
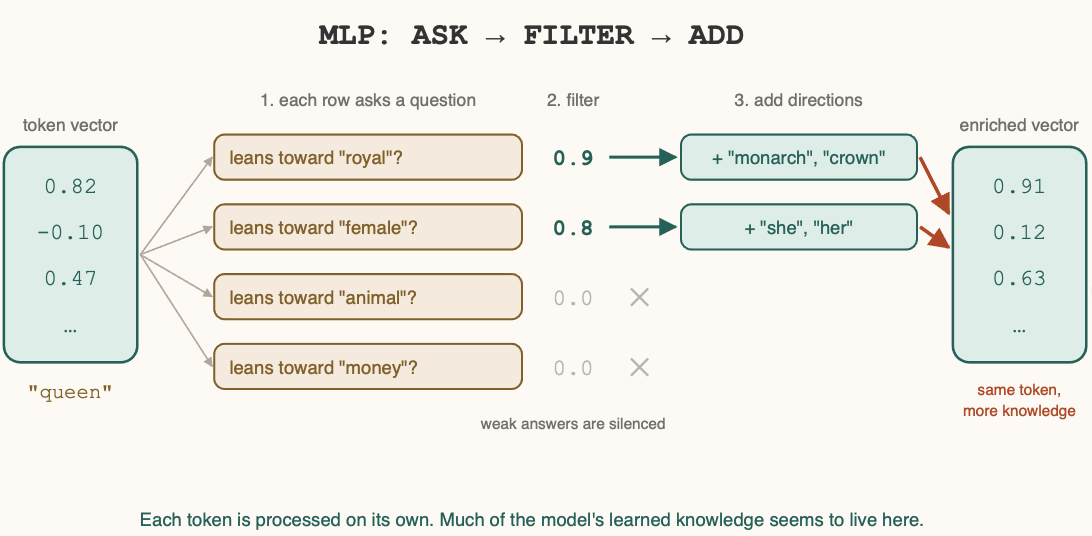
Kuva 8. MLP-osa kysyy, mihin suuntiin vektori on kallellaan, päästää myönteiset vastaukset läpi ja lisää vektoriin uusia suuntia. Token pysyy samana, mutta sen vektori kantaa nyt enemmän tietoa. Kirjoittajan tekoälyllä luoma kuva.
DeepSeek-R1:ssä MLP-osa on toteutettu ns. asiantuntijasekoitteena (mixture of experts, MoE). Useimmissa kerroksissa on 256 rinnakkaista MLP-osaa eli asiantuntijaa, ja pieni reititin valitsee jokaiselle tokenille niistä kahdeksan. Lisäksi yksi jaettu asiantuntija on aina käytössä. Siksi mallin 671 miljardista parametrista vain noin 37 miljardia osallistuu kunkin tokenin laskentaan (Hugging Face, 2025). Malli voi näin sisältää paljon tietoa mutta laskea kerrallaan vähän: tiedostot vievät satoja gigatavuja, mutta yhden tokenin laskenta vastaa paljon pienempää mallia. Nimestään huolimatta asiantuntijat eivät jakaudu siististi aiheittain, kuten lääketieteeseen tai ohjelmointiin. Työnjako syntyy koulutuksessa samaan tapaan kuin huomiopäillä.
Vinkki: 3Blue1Brownin Neural networks -videosarjan jaksossa How might LLMs store facts näkee havainnollisesti, mitä MLP-osassa tapahtuu ja miten se voi tallentaa tietoa. Jakso näyttää myös, miksi tuhansiin lukuihin mahtuu paljon enemmän merkityssuuntia kuin lukuja on.
Monipäinen huomio ja MLP-osa muodostavat yhdessä yhden kerroksen. Kerroksia on pinossa päällekkäin, ja jokainen kerros jalostaa vektoreita hieman pidemmälle. Karkeasti ottaen alemmat kerrokset käsittelevät sanojen muotoa ja lähiympäristöä, ylemmät laajempia merkityksiä. DeepSeek-R1:ssä on 61 kerrosta ja jokaisessa 128 huomiopäätä (Hugging Face, 2025). Suljettujen mallien, kuten Clauden ja GPT:n, vastaavia lukuja ei ole julkaistu.
Todennäköisyyksistä sanaksi: tokenin valinta
Kun vektorit ovat kulkeneet kaikkien kerrosten läpi, viimeisen tokenin vektori kerrotaan vielä yhdellä matriisilla, joka antaa jokaiselle sanaston tokenille yhden luvun eli pisteet (logit). Mitä suuremmat pisteet, sitä paremmin token sopii mallin mukaan seuraavaksi. Pisteet ovat kuitenkin raakalukuja, jotka voivat olla myös negatiivisia, eivätkä ne vielä ole todennäköisyyksiä. Siksi sama softmax-funktio, joka huomiossa muutti vertailujen tulokset osuuksiksi, muuttaa pisteet todennäköisyysjakaumaksi. DeepSeekin tapauksessa jakaumassa on 129 280 vaihtoehtoa (sanaston koko), ja jokaisella on oma todennäköisyytensä tulla seuraavaksi tokeniksi.
Seuraavaksi jakaumasta valitaan yksi token. Tätä kutsutaan otannaksi (sampling). Jos valittaisiin aina todennäköisin token, vastaukset olisivat toisteisia ja jäykkiä. Siksi ohjelmisto arpoo tokenin jakauman mukaan, ja arvontaa säädetään muutamalla asetuksella. Lämpötila (temperature) terävöittää tai tasoittaa jakaumaa: matala lämpötila suosii todennäköisimpiä vaihtoehtoja, korkea antaa harvinaisemmillekin mahdollisuuden. Top-k rajaa arvonnan k:hon todennäköisimpään tokeniin, ja top-p pienimpään joukkoon, jonka yhteenlaskettu todennäköisyys ylittää rajan p (Holtzman ym., 2020).
Malli itse on siis deterministinen: sama teksti tuottaa aina saman todennäköisyysjakauman. Epädeterministisyys syntyy vasta valinnasta, kun jakaumasta arvotaan yksi token. Koska arvottu token syötetään takaisin malliin, yksikin erilainen valinta muuttaa kaikkia seuraavia jakaumia, ja sama kysymys voi johtaa hyvin erilaiseen vastaukseen.
Toiminta menee siis ylätasolla näin:
- Arkkitehtuuri on etukäteen suunniteltu ja painot on opittu.
- Vektorit kulkevat kerrosten läpi (huomio ja MLP-osa), niistä lasketaan jakauma, ja token arvotaan.
Listan ensimmäisen kohdan vaihe tehdään kerran, ennen kuin malli julkaistaan käyttöön. Jälkimmäisen kohdan vaiheet toistuvat jokaisen tokenin kohdalla, kun mallia käytetään.
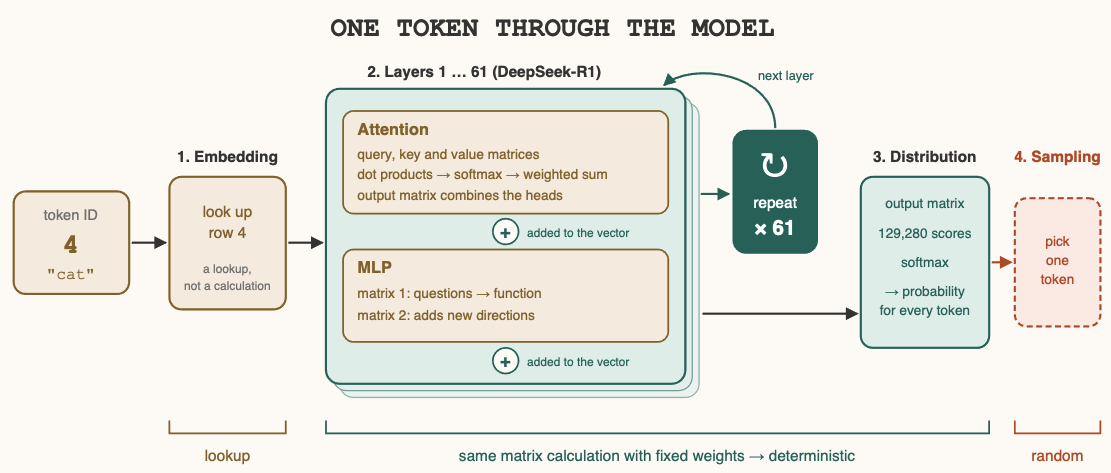
Kuva 9. Mitä ”kerrokset lasketaan” tarkoittaa. Tokenin vektori haetaan upotustaulukosta ja ajetaan kaikkien kerrosten läpi. Lopuksi vektorista lasketaan jakauma, josta token arvotaan. Kaikki arvontaa edeltävä on samaa matriisilaskentaa kiinteillä painoilla. Kirjoittajan tekoälyllä luoma kuva.
Avointen painojen raja menee myös tässä: julkaistu avointen painojen malli sisältää ensimmäisen kohdan, ja jälkimmäinen kohta tehdään siinä ohjelmistossa, joka mallia ajaa.
Vastaus syntyy sana kerrallaan
Nyt voidaan seurata, miten vastaus syntyy. Kun kirjoitat kysymyksen, malli käsittelee ensin koko kehotteen yhdellä kertaa. Tätä vaihetta kutsutaan esitäytöksi (prefill), ja se selittää pienen tauon ennen kuin vastaus alkaa näkyä. Sen jälkeen alkaa purku (decode): malli tuottaa yhden tokenin, se lisätään tekstin perään ja koko teksti syötetään takaisin malliin seuraavaa tokenia varten.
Kuvan esimerkissä kehote on ”The capital of France is”. Esitäytön jälkeen malli valitsee tokenin ”Paris”, sitten pisteen ja lopuksi erityisen lopetustokenin (end-of-sequence), joka kertoo ohjelmistolle, että vastaus on valmis. Ohjelmistossa voi olla lisäksi omia turvarajoja, kuten vastauksen enimmäispituus. Ne selittävät, miksi vastaus joskus katkeaa kesken lauseen.
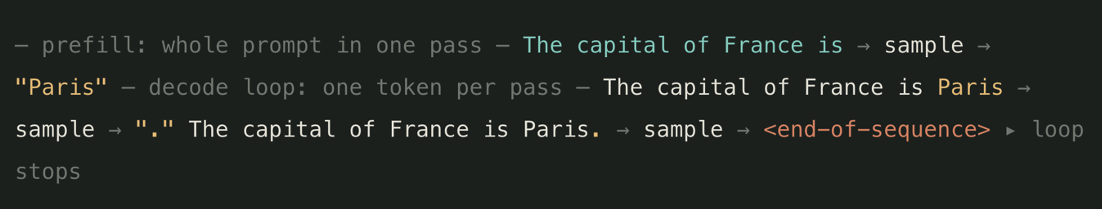
Kuva 10. Esitäytössä koko kehote käsitellään kerralla, purkuvaiheessa syntyy yksi token kierrosta kohden. Silmukka pysähtyy, kun malli tuottaa lopetustokenin. Kirjoittajan tekoälyllä luoma kuva.
Kasvava teksti on mallin ainoa muisti. Malli ei muista edellistä kierrosta, vaan lukee joka kerta koko tähänastisen tekstin. Tämä pitää vastauksen johdonmukaisena, mutta aiheuttaa myös kertautuvan ongelman: kerran kirjoitettua tokenia ei korjata, ja yksikin erilainen valinta vastauksen alussa voi viedä koko loppuvastauksen toiseen suuntaan.
Jotta kaikkea ei tarvitsisi laskea joka kierroksella alusta, ohjelmisto tallentaa aiempien tokeneiden avaimet ja arvot välimuistiin (KV cache). Uuden tokenin kyselyä verrataan vain jo tallennettuihin avaimiin. Välimuisti nopeuttaa laskentaa huomattavasti, mutta se kasvaa jokaisen tokenin myötä. Siksi pitkät keskustelut hidastuvat ja vievät yhä enemmän muistia.
Transformer ei ole ainoa tapa rakentaa kielimallia. Niin sanotuissa tilamalleissa (state-space models), kuten Mamba-arkkitehtuurissa (Gu & Dao, 2023), malli ei vertaa jokaista tokenia kaikkiin aiempiin, vaan tiivistää lukemansa kiinteän kokoiseen tilaan. Tilamallit ovat siksi halvempia pitkillä teksteillä, mutta ne muistavat yksityiskohtia epätarkemmin. Usein käytetään hybridejä, joissa on sekä huomiokerroksia että tilakerroksia.
Hallusinaatio: uskottava jatko ei tarkoita oikeaa vastausta
Hallusinaatioksi kutsutaan tilannetta, jossa malli esittää virheellistä tietoa sujuvasti ja vakuuttavasti. Tärkeintä on ymmärtää, että hallusinaatio syntyy täsmälleen samalla prosessilla kuin oikea vastaus. Missään edellä kuvatussa vaiheessa tulosta ei tarkisteta todellisuutta vasten. Malli tuottaa uskottavan jatkon tekstille, ei välttämättä oikean maailman totuuksia.
Virheellä on kaksi tyypillistä muotoa. Ensimmäisessä jakauma on matala ja levinnyt: malli ei oikeastaan tiedä tarkasti, ja todennäköisyys jakautuu monen vaihtoehdon kesken, joten arvonta voi osua mihin tahansa niistä. Toisessa jakaumassa on korkea piikki väärän tokenin kohdalla: malli on varma, mutta väärässä. Tämä on vaarallisempi tapaus, koska varma virhe näyttää jakaumassa täsmälleen samalta kuin varma oikea vastaus.
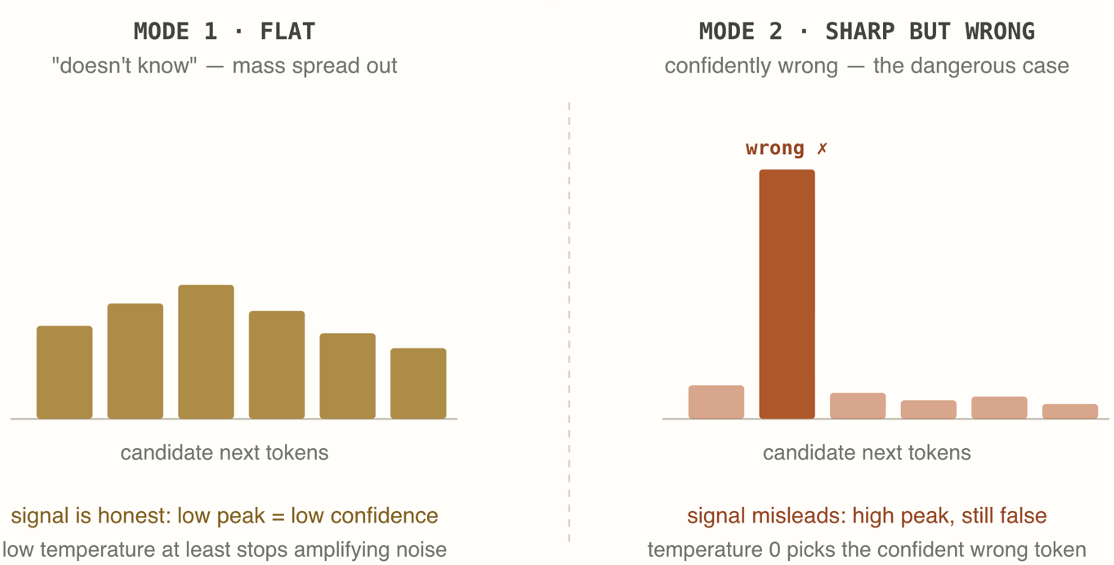
Kuva 11. Kaksi tapaa erehtyä. Vasemmalla malli on epävarma ja todennäköisyys levinnyt. Oikealla malli on varma mutta väärässä, eikä virhettä voi nähdä jakaumasta. Kirjoittajan tekoälyllä luoma kuva.
Lämpötilan laskeminen auttaa vain ensimmäiseen tapaukseen: kun valinta kohdistuu todennäköisimpiin vaihtoehtoihin, satunnaiset harhapolut vähenevät. Varmaan virheeseen se ei auta, sillä nollalämpötilassa malli valitsee väärän tokenin joka kerta. Koska valittu token syötetään uudestaan mallille, tämä pahentaa virheen vaikutusta: yksikin väärä token voi ohjata koko loppuvastauksen väärään suuntaan. Myös koulutus voi kannustaa arvaamaan: jos arvioinnissa palkitaan oikeasta vastauksesta mutta ei rehellisestä ”en tiedä” -vastauksesta, malli oppii arvailemaan (Kalai ym., 2025).
Todelliset korjaukset löytyvät siksi enimmäkseen mallin ulkopuolelta, sitä ympäröivästä ohjelmistosta: tiedonhausta, työkaluista ja lähdeviitteistä, joiden avulla vastauksen voi tarkistaa. Niistä kerron seuraavassa osassa.
Terminologiasta
Lopuksi vielä tämän osan termeistä yhdessä taulukossa. Huomaa, että osa vaiheista tapahtuu itse mallissa ja osa sitä ajavassa ohjelmistossa.
| Mitä tapahtuu | Missä | |
|---|---|---|
| Tokenisointi | Teksti pilkotaan tokeneiksi ja tunnisteiksi. | Ohjelmisto |
| Upotus | Jokaiselle tunnisteelle haetaan vektori upotustaulukosta. Paikkatieto lisätään nykymalleissa vasta huomiossa. | Malli |
| Huomio ja kerrokset | Tokenit hakevat tietoa toisistaan huomiossa, MLP-osat lisäävät niihin opittua tietoa, ja kerrokset jalostavat vektoreita. | Malli |
| Jakauma | Viimeisen kerroksen jälkeen vielä yksi matriisi antaa jokaiselle sanaston tokenille pisteet (logit), ja softmax muuttaa ne todennäköisyyksiksi. | Malli |
| Otanta | Jakaumasta arvotaan seuraava token lämpötilan ja muiden asetusten mukaan. | Ohjelmisto |
| Silmukka | Valittu token lisätään tekstiin, ja kierros alkaa alusta, kunnes tulee lopetustoken. | Ohjelmisto |
Ja tämän osan keskeiset termit suomeksi ja englanniksi:
| Suomeksi | Englanniksi | Selitys |
|---|---|---|
| Sanasto | vocabulary | Kaikki tokenit, jotka malli tuntee. DeepSeek-R1:ssä niitä on 129 280. Jakaumassa on yksi vaihtoehto jokaista sanaston tokenia kohden. |
| Upotus, upotustaulukko | embedding, embedding table | Tokenin vektori ja taulukko, josta se haetaan. Taulukossa on yksi rivi jokaista sanaston tokenia kohden. |
| Sijaintikoodaus | positional encoding | Tieto tokenin paikasta tekstissä. |
| Ei vakiintunutta termiä | rotary position embedding, RoPE | Nykymallien tapa tuoda paikkatieto huomioon: kysely- ja avainvektoreita kierretään eli käännetään tokenin paikan mukaan. |
| Huomio | attention | Mekanismi, jolla tokenit hakevat tietoa toisistaan. |
| Kysely, avain, arvo | query, key, value | Huomion kolme vektoria: mitä etsitään, mitä tarjotaan ja mitä välitetään. |
| Pistetulo | dot product | Kahden vektorin vertailu: mitä paremmin ne osoittavat samaan suuntaan, sitä suurempi luku syntyy. Käytetään huomiossa ja MLP-osassa. |
| Softmax | softmax | Funktio, joka muuttaa luvut positiivisiksi osuuksiksi, joiden summa on yksi. Käytetään huomiossa ja jakaumassa. |
| Huomiojakauma | attention distribution, attention weights | Huomiopainojen kokonaisuus: kuinka suuri osuus huomiosta annetaan kullekin tokenille. Osuuksien summa on yksi, ja ne lasketaan jokaiselle lauseelle erikseen. |
| Huomiopää | attention head | Yksi rinnakkainen huomiolaskenta omine matriiseineen. |
| MLP-osa | multilayer perceptron, feed-forward network | Kerroksen osa, joka käsittelee jokaista tokenia erikseen: kaksi matriisia ja niiden välissä aktivaatiofunktio. Siinä on suurin osa mallin painoista ja ilmeisesti myös suuri osa sen tiedoista. |
| Aktivaatiofunktio | activation function (esim. ReLU) | Funktio, joka käsittelee jokaisen luvun erikseen. ReLU muuttaa negatiiviset luvut nolliksi ja päästää positiiviset läpi. |
| Asiantuntijasekoite | mixture of experts, MoE | MLP-osa jaettuna moneen asiantuntijaan, joista vain osa valitaan kullekin tokenille. Esimerkiksi DeepSeek-R1 käyttää tätä. |
| Reititin | router | Asiantuntijasekoitteen osa, joka valitsee kullekin tokenille käytettävät asiantuntijat. |
| Pisteet | logits | Raakaluvut, jotka malli antaa jokaiselle sanaston tokenille ennen softmaxia. Mitä suuremmat pisteet, sitä paremmin token sopii mallin mukaan seuraavaksi. |
| Otanta | sampling | Seuraavan tokenin arpominen jakaumasta. |
| Lämpötila | temperature | Asetus, joka terävöittää tai tasoittaa jakaumaa. |
| Top-k, top-p | top-k sampling, top-p (nucleus) sampling | Asetukset, jotka rajaavat arvonnan k:hon todennäköisimpään tokeniin (top-k) tai pienimpään joukkoon, jonka yhteenlaskettu todennäköisyys ylittää rajan p (top-p). |
| Esitäyttö, purku | prefill, decode | Kehotteen käsittely kerralla ja vastauksen tuottaminen token kerrallaan. |
| Lopetustoken | end-of-sequence token | Erityinen token, joka kertoo ohjelmistolle, että vastaus on valmis. |
| KV-välimuisti | KV cache | Aiempien tokeneiden tallennetut avaimet ja arvot. |
| Tilamalli | state-space model | Transformerin vaihtoehto, joka tiivistää lukemansa kiinteän kokoiseen tilaan, esimerkiksi Mamba. |
| Hallusinaatio | hallucination | Sujuvasti ja vakuuttavasti esitetty virheellinen tieto. |
Seuraavassa osassa
Tähän asti olemme katsoneet itse mallia ja LLM:n toimintaa. ChatGPT ja Claude ovat kuitenkin paljon enemmän kuin pelkkä malli. Seuraavassa osassa käyn läpi mallin ympärillä olevan ohjelmiston: järjestelmäkehotteen (system prompt), keskustelumuistin, tiedonhaun (RAG), työkalut ja turvasuodattimet. Ne selittävät, miksi sama malli voi käyttäytyä eri sovelluksissa niin eri tavoin ja miten hallusinaatioita yritetään käytännössä torjua.
Lue lisää aiheesta
AnimatedLLM: maallikoille tehty animaatio siitä, miten kielimalli käsittelee tokeneita vaihe vaiheelta. https://animatedllm.github.io/
Transformer Explainer: Georgia Techin interaktiivinen visualisointi, jossa selaimessa toimiva GPT-2-malli näyttää upotukset, huomiomekanismin ja otannan vaihe vaiheelta. https://poloclub.github.io/transformer-explainer/
LLM Visualization: Brendan Bycroftin kolmiulotteinen animaatio, joka näyttää mallin laskennan matriisikertolaskuina. https://bbycroft.net/llm
The Illustrated Transformer: Jay Alammarin kuvitettu johdatus transformer-arkkitehtuuriin ja huomiomekanismiin. https://jalammar.github.io/illustrated-transformer/
3Blue1Brown: Neural networks -videosarja YouTubessa, erityisesti jaksot transformereista, huomiomekanismista ja MLP-osasta (How might LLMs store facts). https://www.youtube.com/playlist?list=PLZHQObOWTQDNU6R1_67000Dx_ZCJB-3pi
Lähteet
Geva, M., Schuster, R., Berant, J., & Levy, O. (2021). Transformer feed-forward layers are key-value memories. Proceedings of the 2021 Conference on Empirical Methods in Natural Language Processing, 5484–5495. https://arxiv.org/abs/2012.14913
Gu, A., & Dao, T. (2023). Mamba: Linear-time sequence modeling with selective state spaces. arXiv. https://arxiv.org/abs/2312.00752
Holtzman, A., Buys, J., Du, L., Forbes, M., & Choi, Y. (2020). The curious case of neural text degeneration. International Conference on Learning Representations. https://arxiv.org/abs/1904.09751
Hugging Face. (2025). deepseek-ai/DeepSeek-R1 [Mallin tiedostot]. https://huggingface.co/deepseek-ai/DeepSeek-R1
Kalai, A. T., Nachum, O., Vempala, S. S., & Zhang, E. (2025). Why language models hallucinate. arXiv. https://arxiv.org/abs/2509.04664
Mikolov, T., Yih, W., & Zweig, G. (2013). Linguistic regularities in continuous space word representations. Proceedings of the 2013 Conference of the North American Chapter of the Association for Computational Linguistics: Human Language Technologies, 746–751. https://aclanthology.org/N13-1090/
Vaswani, A., Shazeer, N., Parmar, N., Uszkoreit, J., Jones, L., Gomez, A. N., Kaiser, Ł., & Polosukhin, I. (2017). Attention is all you need. Advances in Neural Information Processing Systems, 30. https://arxiv.org/abs/1706.03762