
LLM-ohjelmisto on paljon enemmän kuin vain kielimalli. Suuri osa siitä, mikä näyttää käyttäjästä älykkäältä, tapahtuu mallin ulkopuolella olevassa ohjelmistossa.
Malli on moottori, sovellus on auto
Osassa 2 malli kuvattiin vihreällä katkoviivalla rajatulla laatikolla: se ottaa vastaan lukuja ja antaa ulos lukuja eikä näe tekstiä lainkaan. Sen ympärillä oleva päättelymoottori (inference engine) muuttaa tekstin tokeneiksi, valitsee seuraavan tokenin ja pyörittää silmukkaa, jossa vastaus syntyy token kerrallaan. Kun käytät ChatGPT:tä tai Claudea, tämänkin ympärillä on vielä yksi kerros: sovellus, joka päättää, mitä mallille ylipäätään lähetetään ja mitä sen vastaukselle tehdään.
Malli on kuin auton moottori: yksinään se ei kuljeta ketään mihinkään. Auton siitä tekevät kori, voimansiirto, ohjaus, jarrut ja muu laitteisto moottorin ympärillä. Päättelymoottori on tässä vertauksessa moottorin sytytys ja polttoaineen syöttö: se saa moottorin käymään, mutta ei tee siitä autoa.
Sovelluksen loogiset osat
LLM-ohjelmiston voi jakaa muutamaan loogiseen osaan. Variaatiota toteutuksissa tietysti on, mutta usein ainakin nämä osat löytyvät.
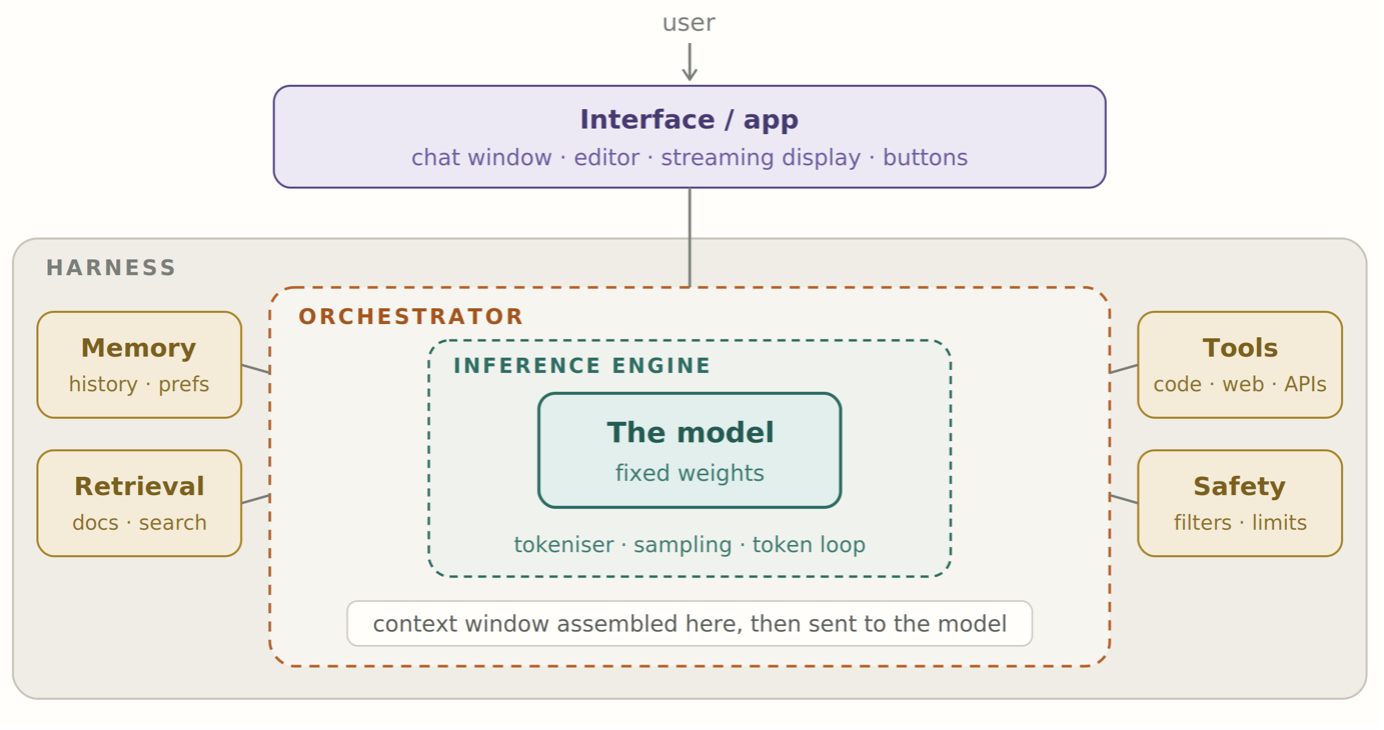
Kuva 1. LLM-ohjelmiston loogiset osat. Kirjoittajan tekoälyllä luoma kuva.
Englanniksi käyttöliittymän (interface) ja päättelymoottorin välissä olevaa ohjelmistoa kutsutaan usein nimellä harness. Kuvassa se on harmaa alue: orkestroija ja sen apupalvelut.
Käyttöliittymä on se, minkä näet: keskusteluikkuna, koodieditori tai puhesovellus. Se ottaa kysymyksesi vastaan ja näyttää vastauksen sitä mukaa kuin tokeneita syntyy.
Orkestroija (orchestrator) on sovelluksen ohjauskeskus. Se kokoaa päättelymoottorille, ja sitä kautta mallille, lähetettävän syötteen, kutsuu mallia, tulkitsee vastauksen ja päättää seuraavasta askeleesta. Suurin osa siitä toiminnallisuudesta, jota kutsumme LLM-tuotteeksi, asuu täällä.
Muisti (memory) tallentaa keskusteluhistorian ja käyttäjän asetukset, jotta ne voidaan antaa mallille uudelleen. Tiedonhaku (retrieval) etsii kysymykseen liittyvää tietoa asiakirjoista tai verkosta ja liittää sen syötteeseen. Työkalut (tools) antavat mallin pyytää toimintoja, kuten koodin ajamista, verkkohakua tai tiedoston lukemista. Turvasuodattimet (safety) tarkistavat syötettä ja vastausta ja pitävät kokonaisuuden haluttujen rajojen sisällä.
Kaikki nämä toimivat samalla periaatteella: ne muuttavat sitä tekstiä, jonka malli saa luettavakseen. Mallille itselleen kaikki on vain token-ketjuja. Kaksi palvelua voi käyttää samaa mallia, mutta ohjelmisto sen ympärillä voi olla hyvin erilainen.
Järjestelmäkehote: ohjeet ennen ensimmäistä sanaa
Ennen kuin kysymyksesi päätyy mallille, orkestroija lisää sen eteen järjestelmäkehotteen (system prompt). Se on sovelluksen tekijän kirjoittama ohjeteksti, joka kertoo mallille esimerkiksi päivämäärän, palvelun nimen, käytettävissä olevat työkalut, mitä se saa ja ei saa tehdä ja millä tyylillä vastata. Mallille järjestelmäkehote on samanlaista tekstiä kuin oma kysymyksesi. Ero on siinä, että se tulee ensin ja että jälkikoulutus on opettanut mallin painottamaan sitä. Ehdoton sääntö se ei silti ole: kehote ohjaa mallia vahvasti, mutta ei pakota sitä.
Järjestelmäkehotteet ovat yleensä yrityssalaisuuksia, mutta esimerkiksi Anthropic julkaisee Claude-sovellustensa järjestelmäkehotteet dokumentaatiossaan (Anthropic, 2026). Niistä näkee konkreettisesti, kuinka suuri osa palvelun käytöksestä ei ole painoissa vaan tekstissä, joka annetaan mallille jokaisen keskustelun alussa. Sama avoin malli voi toimia yhdessä yrityksessä asiakaspalvelubottina ja toisessa koodausavustajana: painot ovat samat, järjestelmäkehote eri. Jos vertailet Anthropicin nykyistä kehotetta ensimmäisiin versioihin, niissä on iso ero. Monenlaista rajoitetta on lisätty ja nykyinen järjestelmäkehote on jo aika pitkä.
Ohjelmiston/mallin käyttämissä järjestelmäkehotteissa tai kehotteisiin lisättävissä osissa piilee myös riskejä. Jos joku onnistuu ujuttamaan omia ohjeitaan mallin luettavaksi käyttäjän tietämättä esimerkiksi verkkosivulle piilotettuna tekstinä, malli voi noudattaa niitä. Tätä hyökkäystä kutsutaan kehoteinjektioksi (prompt injection), ja siihen palataan sarjan riskejä käsittelevässä osassa.
Miksi malli tuntuu muistavan sinut
Osassa 2 todettiin, että käyttöön otettu malli ei opi keskustelusta, koska sen painot on jäädytetty opetuksen jälkeen. Silti hyvä avustaja tuntuu muistavan nimesi, projektisi ja viime viikon keskustelun. Muisti ei ole mallissa vaan ohjelmistossa, joka tallentaa tietoa ja antaa sen mallille uudelleen jokaisella kierroksella. Tämä tapahtuu kolmella tasolla.
Saman keskustelun sisällä koko keskustelu lähetetään uudelleen. Kun lähetät viestin, sovellus ei lähetä pelkkää uutta viestiä vaan koko tähänastisen keskustelun, ja malli lukee sen joka kerta alusta. Kun keskustelu kasvaa yli konteksti-ikkunan (context window) eli suurimman tekstimäärän, jonka malli pystyy kerralla käsittelemään, ohjelmisto joko tiivistää vanhimmat osat lyhyeksi yhteenvedoksi tai pudottaa ne pois. Pois pudonneen malli todella unohtaa, ja tiivistetystä jää jäljelle vain yhteenveto.
Keskustelujen välillä muisti on erillinen tietovarasto. Osa palveluista tallentaa sinusta tietoja, kuten asetuksia ja aiemmissa keskusteluissa kertomiasi asioita tai käyttöön liittyviä mieltymyksiäsi, omaan tietokantaansa mallin ulkopuolelle. Uuden keskustelun alussa sovellus hakee niistä olennaiset ja lisää ne syötteeseen ennen viestiäsi.
Tarvittaessa sovellus hakee lisää tietoa. Se voi etsiä aiemmista keskusteluistasi tai lataamistasi tiedostoista kohdat, jotka liittyvät kysymykseen, ja liittää ne mukaan tilanteesta riippuen.
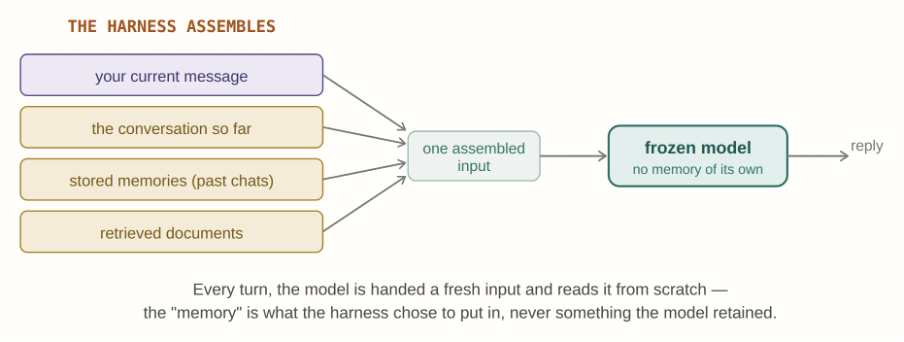
Kuva 2. Ohjelmisto kokoaa jokaisella kierroksella yhden syötteen: uuden viestin, tähänastisen keskustelun, tallennetut muistot ja haetut asiakirjat. Malli lukee syötteen alusta, eikä muista itse mitään. Kirjoittajan tekoälyllä luoma kuva.
Tämän voi myös testata. Kun muistiominaisuuden kytkee pois päältä tai tallennetun historian poistaa, ohjelma ei enää muistakaan aiempia asioita. Malli ei muuttunut miksikään, vain sen saama syöte muuttui.
Huomaa, että palveluntarjoajat voivat käyttää keskusteluja tulevien mallien koulutukseen, jos LLM-sovelluksen asetukset sen sallivat. Mutta silloinkin oppiminen tapahtuu myöhemmin, uudessa mallissa, eikä siinä mallissa, jonka kanssa keskustelet tällä hetkellä.
Tiedonhaulla voi vähentää hallusinaatioita
Osassa 3 todettiin, että hallusinaatio syntyy samasta mekanismista kuin oikea vastaus: malli tuottaa uskottavan jatkon eikä tarkista todenmukaisuutta. Pelkillä asetuksilla tätä ei saa korjattua, mutta ympäröivällä ohjelmistolla sitä voi yrittää. Tärkein keino on tiedonhaku (retrieval-augmented generation, RAG). Ennen kuin malli vastaa, sovellus hakee kysymykseen liittyviä tekstejä esimerkiksi yrityksen asiakirjoista tai verkosta ja liittää ne syötteeseen. Silloin todennäköisin jatko on todennäköisemmin oikea, koska oikea tieto on mallin luettavana eikä sitä muodosteta vain mallin painoista.
Tiedonhaku auttaa myös silloin, kun mallin koulutusaineisto on vanhentunut tai kun tieto on yksityistä, kuten organisaation omat ohjeet. Se ei kuitenkaan tee mallista erehtymätöntä. Malli voi tulkita lähteen väärin, ja jos haku tuo väärän tekstin, vastaus perustuu siihen. Siksi hyvät sovellukset näyttävät lähteet, jotta käyttäjä voi tarkistaa ne.
Työkalut ja agentit
Työkalujen avulla malli voi tehdä muutakin kuin tuottaa tekstiä. Malli ei itse aja koodia eikä hae verkosta, vaan se kirjoittaa vastaukseksi pyynnön sovitussa muodossa, esimerkiksi ”hae verkosta X” tai ”aja tämä koodi”. Orkestroija tunnistaa pyynnön, suorittaa sen ja antaa tuloksen mallille uutena syötteenä. Sen jälkeen malli jatkaa: se voi pyytää lisää tai kirjoittaa lopullisen vastauksen.
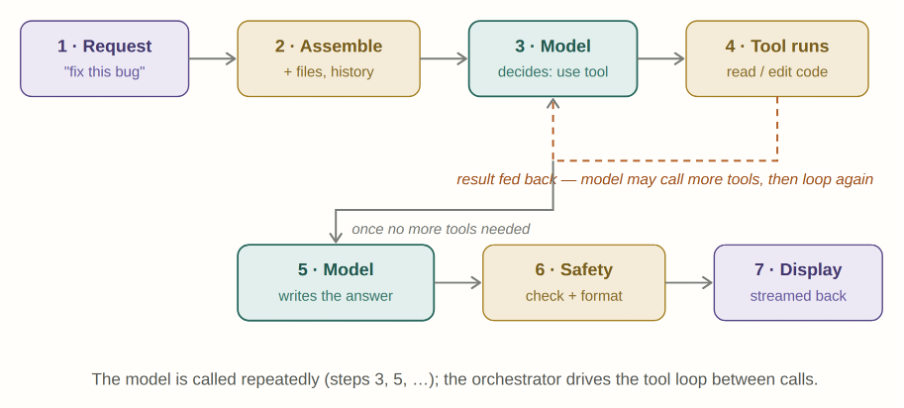
Kuva 3. Yksi pyyntö, monta mallin kutsua. Esimerkissä ohjelmointiavustaja korjaa virhettä: malli päättää käyttää työkalua, työkalu lukee tai muokkaa koodia, tulos palautetaan mallille ja kierros toistuu, kunnes työkaluja ei enää tarvita. Vasta sitten malli kirjoittaa vastauksen, joka tarkistetaan ja näytetään käyttäjälle. Kirjoittajan tekoälyllä luoma kuva.
Kun tällaista silmukkaa ajetaan monta kierrosta ja mallilla on käytössään useita työkaluja, puhutaan agentista (agent). Kuvassa on itse asiassa kaksi sisäkkäistä silmukkaa: jokaisen mallin kutsun sisällä tokenit syntyvät yksi kerrallaan, kuten osassa 3 kuvattiin, ja kutsujen välissä orkestroija ajaa työkaluja. Juuri tämä agenttisilmukka (agent loop) tekee tekstin ennustajasta jotain, joka voi toimia laajemmin eikä vain tuottaa tekstiä.
Tämä kyvykkyys tuo mukanaan jällen myös riskejä. Agentti voi valita väärän työkalun: se voi vaikka poistaa tiedoston tai tehdä ostoksen, joka ei ollutkaan käyttäjän haluama toiminto. Riski kasvaa, kun agentti lukee verkkosivuja tai asiakirjoja: niihin piilotetut ohjeet voivat saada sen käyttämään myös työkalujaan hyökkääjän hyväksi. Siksi monet sovellukset pyytävät ihmisen vahvistuksen ennen peruuttamattomia toimintoja.
Turvallisuus on kerroksittaista
Mallin turvallisuus ei ole yhden asian varassa. Jälkikoulutus on opettanut mallin kieltäytymään haitallisista pyynnöistä, kuten osassa 2 kerrottiin. Sen lisäksi sovellus voi tarkistaa sekä syötteen että vastauksen erillisillä suodattimilla. Ne yrittävät tunnistaa myös kehoteinjektiot ja jailbreak-yritykset eli kehotteet, joilla mallia yritetään houkutella ohittamaan omat rajansa. Sovellus voi myös rajoittaa käyttömääriä ja vastausten pituutta sekä estää tietyt toiminnot kokonaan. Kerrokset täydentävät toisiaan: jos yksi pettää, toinen voi vielä pysäyttää ajon.
Kerroksellisuus selittää myös, miksi avoimien painojen malli voi käyttäytyä eri tavalla kuin sama malli palveluna. Kun lataat painot ja ajat ne itse, mukana ei tule palvelun järjestelmäkehotetta eikä suodattimia. Mukana on vain se, mitä painoihin on koulutettu, ja suodattimet ovat mallin käyttäjän vastuulla. Jälkikoulutuksella opetetut rajat voi myös kouluttaa pois, ja siksi verkosta löytyy avoimista malleista ”uncensored”-versioita.
Sama malli, eri käyttökokemus
Kaikki edellä oleva tarkoittaa sitä, että jos vertaamme kahta tekoälypalvelua, vertaamme oikeastaan mallien ympärille rakennettuja ohjelmistoja, emme itse malleja. Sama malli voi olla verkkosivun keskusteluikkunassa, ohjelmointityökalussa tai yrityksen omassa järjestelmässä, mutta käyttäjän kokemus voi olla hyvin erilainen.
Tuore esimerkki tulee Ruotsista. Ruotsin valtioneuvoston kanslia Regeringskansliet esti lokakuussa 2026 työntekijöiltään ChatGPT:n ja Clauden selainkäyttöliittymät ja ohjasi heidät käyttämään organisaation hyväksymää Microsoft Copilotia. Samat ChatGPT- ja Claude-mallit ovat silti työntekijöiden käytettävissä kyseisen alustan kautta (SVT, 2026). Ongelma ei siis ollut itse malleissa vaan siinä, mitä kautta niitä käytettiin. Datan ja sen käsittelyn ei haluttu missään vaiheessa kukevan organisaation hallinnan ulkopuolelle ja tämä saavutettiin, kun käytettiin organisaation hyväksymien sopimusten mukaan tuotettua ohjelmistoa. Usein kuluttaja-AI-palveluissa tietosuoja ei ole riittävällä tasolla ja käyttäjän dataa voidaan käsitellä mm. EU:n ulkopuolella ja käyttää mallien opettamiseen.
Painojen ja ympäröivän ohjelmiston ero näkyy myös näin: Anthropicin tutkijat osoittivat lokakuussa 2026, että pienet tekoälyagentit pystyvät jo suorittamaan monia vaiheita, joilla ne voisivat kopioida itsensä halpoihin verkkoon kytkettyihin laitteisiin. Kopioitaessa painot pysyvät muuttumattomina, mutta niitä ympäröivä ohjelmisto oppii sukupolvesta toiseen: jokainen uusi kopio perii edeltäjänsä muistiinpanot ja toimintatavat (Zhou & Freeman, 2026). Tässäkin on siis riski väärinkäytölle, tai ainakin ennakoimattomalle ja yllättävälle toiminnalle.
Terminologiasta
Lopuksi jälleen keskeiset termit suomeksi ja englanniksi. Kaikille ei ole vakiintunutta termiä.
| Suomeksi | Englanniksi | Selitys |
|---|---|---|
| Ympäröivä ohjelmisto, ”valjaat” | harness | Mallin ympärillä oleva ohjelmisto, joka kokoaa syötteen, kutsuu mallia ja käsittelee vastauksen. |
| Käyttöliittymä | user interface, UI | Sovelluksen osa, jonka käyttäjä näkee: keskusteluikkuna, koodieditori tai puhesovellus. Se välittää kysymyksen ja näyttää vastauksen. |
| Orkestroija | orchestrator | Sovelluksen ohjauslogiikka, joka kokoaa mallille lähetettävän syötteen ja päättää seuraavasta askeleesta. |
| Päättelymoottori | inference engine | Mallia ajava ohjelmisto, joka muuttaa tekstin tokeneiksi, valitsee seuraavan tokenin ja tuottaa vastauksen token kerrallaan. |
| Järjestelmäkehote | system prompt | Sovelluksen tekijän rakentamat vakio-ohjeet, jotka lisätään jokaisen keskustelun alkuun. |
| Konteksti-ikkuna | context window | Suurin tekstimäärä tokeneina, jonka malli voi käsitellä kerralla. |
| Muisti | memory | Mallin ulkopuolinen tietovarasto, josta sovellus saa lisätietoja käyttäjän historiasta kysymyksiä käsitellessään. |
| Tiedonhaku | retrieval-augmented generation, RAG | Kysymykseen liittyvien tekstien haku ja liittäminen syötteeseen ennen vastausta. |
| Työkalu | tool | Toiminto, jota malli voi pyytää työkalukutsulla (tool call) ja jonka ohjelmisto suorittaa, esimerkiksi haku, koodin ajo tai viestin lähetys. |
| Agentti | agent | Järjestelmä, jossa malli käyttää työkaluja monta kierrosta saavuttaakseen tavoitteen. Tätä toistuvaa kierrosta kutsutaan agenttisilmukaksi (agent loop). HUOM: “AI-agentilla” tarkoitetaan usein myös monenlaisia AI-järjestelmiä, joita ihmiset voivat käyttää. Termi on epämääräinen. |
| Kehoteinjektio | prompt injection | Hyökkäystekniikka. Mallin luettavaksi ujutetut ohjeet, joita malli voi erehdyksessä noudattaa. Ohjeita voidaan ujuttaa monella eri tavalla: sähköposteissa, dokumenteissa, äänisyötteinä jne. |
| Jailbreak | jailbreak | Kehote, jolla mallia yritetään houkutella ohittamaan kehittäjän sille asettamia rajoitteita. |
| ”Suojakaiteet”, turvasuodattimet | guardrails | Mallin ympärille rakennetut tarkistukset ja rajat, jotka suodattavat syötettä ja vastausta ja estävät epätoivotuina pidettäviä toimintoja. |
Seuraavassa osassa
Seuraavassa osassa katsotaan kielimallien kenttää laajemmin: miten avoimet painot ja suljetut, rajapinnan kautta käytettävät mallit, eroavat. Myös miksi kiinalaiset avointen painojen mallit ovat saaneet paljon huomiota ja mitä Euroopassa tehdään täysin avointen mallien eteen. Esittelen lisäksi, miten tämä sama moottori tuottaa myös kuvia ja millainen on tekoälyn kenttä kielimallien ulkopuolella.
Lue lisää aiheesta
Anthropic: Claude-sovellusten järjestelmäkehotteet. Täältä näet, millaiset ohjeet malli saa ennen ensimmäistä viestiäsi. https://platform.claude.com/docs/en/release-notes/system-prompts
Anthropic: Building effective agents. Käytännönläheinen kuvaus siitä, miten työkaluja käyttäviä järjestelmiä rakennetaan ja milloin agenttia ei kannata rakentaa. https://www.anthropic.com/engineering/building-effective-agents
Karpathy, A.: Intro to Large Language Models -video YouTubessa. Videon loppupuolella käsitellään ajatusta kielimallista uudenlaisen käyttöjärjestelmän ytimenä, jonka ympärille työkalut ja muisti rakentuvat. https://www.youtube.com/watch?v=zjkBMFhNj_g
Lähteet
Anthropic. (2026). System prompts [Julkaisutiedot]. https://platform.claude.com/docs/en/release-notes/system-prompts/overview
SVT Nyheter. (2026, 23. lokakuuta). AI-tjänster spärras på Regeringskansliet. https://www.svt.se/nyheter/inrikes/ai-tjanster-sparras-pa-regeringskansliet
Zhou, W., & Freeman, D. (2026). AI models may be capable of self-replicating without access to a datacenter. Anthropic. https://www.anthropic.com/research/self-replicating-ai